新闻资讯
NVLink 算力集群搭建有哪些关键指标?华锐集团用 20 年机房运营经验为你拆解
在人工智能大模型训练与推理需求爆发的当下,算力集群的搭建早已不是简单堆砌 GPU 显卡那么简单。尤其当企业转向大规模并行计算时,传统 PCIe 互联的带宽瓶颈会被迅速放大,导致多卡协同效率低下,模型训练时间被无限拉长。这正是 NVLink 算力集群 价值凸显的地方——它通过高带宽、低延迟的直连架构,将多张高端 GPU 组成一个“超级显卡”,彻底释放并行计算的真实性能。
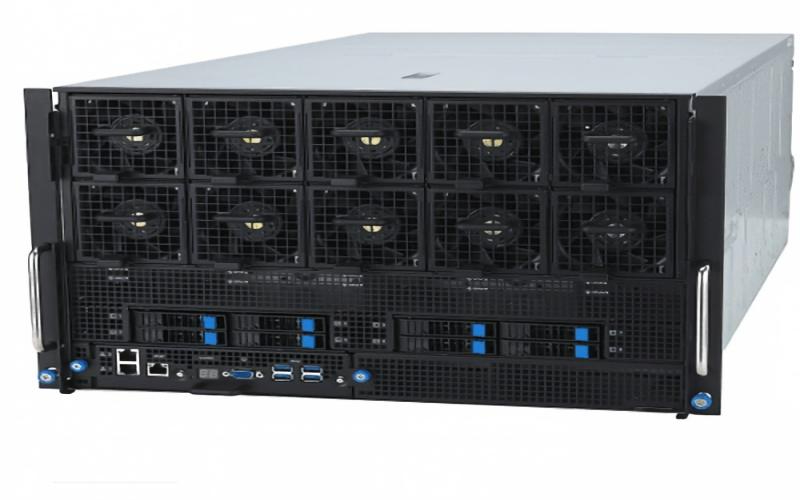
但必须承认,NVLink 算力集群的搭建并非“买卡插上就能跑”,它涉及网络拓扑、散热功耗、存储协同、调度平台等一系列系统工程。稍有不慎,轻则性能折损,重则集群频繁故障。接下来,我们以华锐集团多年 IDC 机房运营与算力交付经验为基础,拆解 NVLink 算力集群搭建中容易被忽视的关键指标,为你的智能化升级提供一份可落地的参考。
一、网络互联架构:NVLink 域与交换拓扑怎么选
1.1 NVLink 全互联与 3D 环拓扑的取舍
NVLink 提供了两种典型的 GPU 互联模式:全互联(NVLink Fully Connected)和 3D 环拓扑(NVLink 3D Torus)。全互联模式下,每张 GPU 与其余所有 GPU 直连,适合 8 卡规模内的训推一体场景,延迟低、带宽高。而 3D 环拓扑更适合 32 卡以上的超大规模集群,虽然单跳延迟略高,但可扩展性更强。华锐集团在实际交付中发现,不少企业盲目追求大集群,却忽略了业务训练并行度与拓扑的匹配,导致资源闲置率居高不下。
1.2 NVSwitch 层级与胖树架构的必要性
当集群规模超过单台服务器承载能力时,就需要引入 NVSwitch 构建跨节点互联。这里的关键指标是 NVSwitch 的端口速率与非阻塞带宽比。一个合格的 NVLink 算力集群,应当保证任意两张跨节点 GPU 之间的通信带宽不低于节点内互联带宽的 80%,否则就会出现“木桶效应”。华锐集团在为客户搭建大规模集群时,通常会按照胖树(Fat-Tree)架构规划三层 NVSwitch 网络,确保数据面带宽无收敛,这也是保障大模型分布式训练稳定的核心前提。
二、GPU 算力选型:从 A800 到 B300 的适配逻辑
2.1 显存容量与计算密度如何平衡
很多企业选卡时只盯着峰值算力(TFLOPS),却忽视了显存容量与计算密度的匹配。以 1750 亿参数的大模型预训练为例,若单卡显存无法承载模型切片与梯度累积,即便算力再高也会被频繁的显存换出拖垮。华锐集团运营的算力集群中,既部署了 H800 用于高吞吐训练,也保留了 A800 应对推理与微调场景——不同业务阶段搭配不同卡型,才能做到成本与性能的双优。
2.2 卡间互联带宽对实际训练效率的影响
这里要特别强调 NVLink 带宽的真实意义。以单卡 900GB/s 的 NVLink 带宽计算,8 卡互联的理论聚合带宽是 7.2TB/s,但实际能跑出多少取决于通信库与并行策略。华锐集团在算力调优中会重点关注 NCCL 通信库的测试结果,确保 AllReduce 操作的实际带宽利用率不低于理论峰值的 70%。这一指标,往往决定了训练迭代速度能否逼近线性扩展的理想状态。
三、散热与供电:绿电 PUE 与整柜功率密度
3.1 液冷方案在 NVLink 集群中的优先级
高端 GPU 的整机功耗轻松突破 10kW 甚至更高,传统风冷已逼近物理极限。液冷板式散热能够将 CPU 与 GPU 的热量带离,显著降低风扇噪音与能耗。华锐集团在自有机房与客户定制化机房中,普遍采用冷板式液冷与风冷混合方案,使整柜功率密度提升至 30kW 以上,同时将 PUE(电能利用效率)降至 1.3 以下。这不仅是对硬件寿命的保护,更是对长期运营成本的有效控制。
3.2 冗余供电与母线架构的可靠性设计
NVLink 集群对供电连续性极其敏感,瞬时掉电可能导致训练任务中断甚至数据损坏。因此,在机房侧需要采用 2N 冗余 UPS 系统,在机柜侧引入智能母线配电,支持每路插接箱的独立监控与动态负载均衡。华锐集团坚持的“双路供电、毫秒级切换”标准,能够将意外断电对训练任务的影响降到低,这也是企业客户愿意长期合作的重要原因。
四、软件栈与调度:从裸金属到容器化的弹性演进
4.1 算力调度平台如何避免 GPU 碎片化
集群搭建的硬件部分只是开始,真正的考验在于软件调度。一个优秀的算力调度平台,应当支持 GPU 显存与算力的精细化切分,将一张卡同时分配给多个推理任务使用,避免资源碎片化造成的浪费。华锐集团自主研发的算力调度系统,能够实现对异构 GPU 资源的统一纳管,支持训练任务优先级抢占与空闲资源回收,让集群利用率从行业平均的 40% 提升至 70% 以上。
4.2 分布式存储与 Checkpoint 机制的协同
大模型训练对存储吞吐量有极高要求,尤其是 Checkpoint 定期保存环节。若存储系统存在 IO 瓶颈,每次保存都可能阻塞训练流水线数分钟。因此,搭建 NVLink 算力集群时,应同步规划高性能并行文件存储(如 Lustre 或 GPFS),并配置独立的 Checkpoint 写入路径。华锐集团在交付算力服务时,会将存储性能测试纳入验收标准,确保读写带宽与 IOPS 满足客户对训练稳定性与容灾恢复的需求。
4.3 互联网络验证:NCCL 测试与故障回溯
集群上线前的后一道关卡,是全面压测 NVLink 互联的稳定性。建议使用 NCCL 的 AllReduce、AllGather 等基准测试工具,在满负载下连续运行 24 小时以上,重点观察带宽曲线是否平稳、是否有掉线重连现象。同时,应建立完善的监控告警体系,对 NVLink 链路误码率与重传率进行实时追踪,一旦异常立即定位故障 GPU 或交换机端口,避免“带病运行”拖垮整体业务。
五、算力租赁模式:为什么托管比自建更划算
5.1 固定资产投入的隐性成本分析
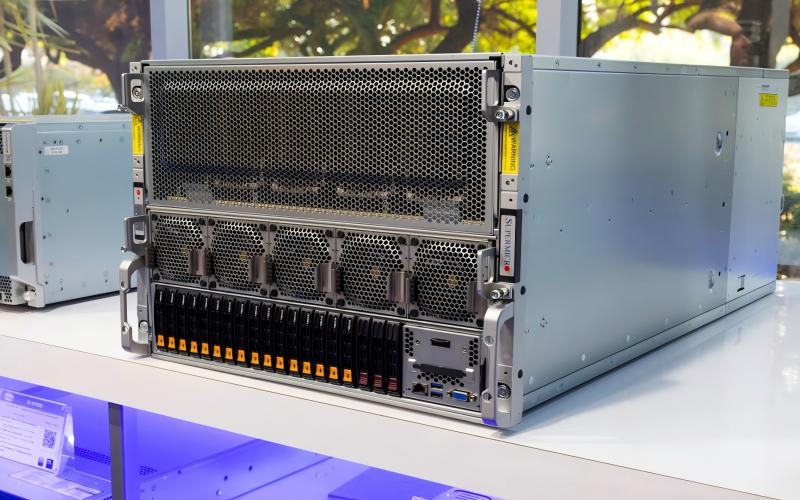
自建一个中等规模的 NVLink 算力集群,除了采购高端 GPU 与 NVSwitch 交换机的显性成本,还包含机房改造、制冷扩容、电力增容、运维团队招聘等一揽子隐性支出。尤其对于业务处于快速迭代期的企业,算力需求呈脉冲式波动,自建集群的闲置率往往高得惊人。华锐集团曾帮客户测算过:采用算力租赁与整机托管模式,综合 TCO(总拥有成本)通常能比自建降低 30% 以上,且无需承担硬件快速迭代的折旧风险。
5.2 弹性扩容如何平滑承接业务流量波峰
算力租赁的另一大优势在于弹性。当企业推出新模型或遭遇线上流量突增时,租赁集群可以在数小时内完成横向扩容,快速承接峰值推理压力;业务回落后再平滑释放资源,实现成本的按需支付。华锐集团作为 Tokey 算力源头工厂,依托自有智算机房集群,能够提供 7×24 小时的不间断运维保障,将复杂的硬件链路管理与故障排查工作全部承接,让企业团队能够更专注地投入到算法迭代与业务落地中。
5.3 选择算力服务商时应重点考察的三个维度
一是考察服务商是否具备自有机房与真实算力储备,而非单纯的转租方;二是考察其是否具备全栈服务能力,例如能否协同提供数据标注、AI 应用落地等配套支持;三是考察其合规体系与安全标准,尤其是数据本地存储与操作可审计能力。华锐集团从 IDC 数据中心深耕 20 年走来,现已形成“AI 算力 + AI 云手机 + AI 超级员工 + AI 数据标注”的一体化服务生态,能够为不同行业客户提供从底层基建到上层应用的连续服务保障。如果你正在评估模组化算力集群方案,与其在碎片化的供应商之间反复比对,不如与像华锐集团这样具备源头算力支撑的综合商进行一次深度对接,也许能为你打开一条更省心、更的智能化落地路径。